





Ένα bot επισκέπτεται το site σου. Διαβάζει άρθρα, ανοίγει σελίδες προϊόντων ή ζητά επανειλημμένα ένα URL που δεν υπάρχει. Πρέπει να το αφήσεις ή να το μπλοκάρεις; Η απάντηση δεν βρίσκεται μόνο στο όνομά του, ούτε στο αν το dashboard το χαρακτηρίζει «AI».
Το ουσιαστικό ερώτημα είναι διαφορετικό: ποιος ζητά πρόσβαση, για ποιον σκοπό, σε ποιο περιεχόμενο και με ποιο κόστος ή ρίσκο; Ένας crawler που ανακαλύπτει δημόσιες σελίδες δεν είναι το ίδιο με έναν agent που επιχειρεί να ολοκληρώσει μια ενέργεια για λογαριασμό χρήστη. Και κανένας από τους δύο δεν αποκτά δικαίωμα πρόσβασης σε ιδιωτικά δεδομένα επειδή δηλώνει γνωστό όνομα.
Ο οδηγός που ακολουθεί προτείνει ένα πρακτικό πλαίσιο για marketers, publishers και ιδιοκτήτες e-shop. Στόχος δεν είναι να επιλέξεις ανάμεσα στο «όλα ανοιχτά» και στο «όλα κλειστά», αλλά να δημιουργήσεις μια ελεγχόμενη, καταγεγραμμένη πολιτική πρόσβασης.
Η σύντομη απάντηση: Τι επιτρέπουμε και τι περιορίζουμε;
- Δημόσιο περιεχόμενο που θέλουμε να ανακαλύπτεται: εξετάζουμε πρόσβαση για επαληθευμένους crawlers που εξυπηρετούν αυτόν τον σκοπό, με παρακολούθηση συμπεριφοράς και επιβάρυνσης.
- Συλλογή για εκπαίδευση μοντέλων: αποφασίζουμε ξεχωριστά, βάσει δικαιωμάτων περιεχομένου και επιχειρηματικής πολιτικής, όπου ο πάροχος προσφέρει διακριτούς ελέγχους.
- Προσωπικά δεδομένα και ιδιωτικές λειτουργίες: απαιτούμε πραγματικό έλεγχο πρόσβασης. Δεν βασιζόμαστε στο robots.txt.
- Ενέργειες που αλλάζουν δεδομένα ή δημιουργούν συναλλαγές: απαιτούμε κατάλληλη εξουσιοδότηση και δικλίδες ασφαλείας, είτε τις εκτελεί άνθρωπος είτε agent.
- Επιθετική ή ύποπτη συμπεριφορά: εφαρμόζουμε τεχνικούς περιορισμούς ανάλογα με το περιστατικό, χωρίς να περιμένουμε να αποδειχθεί ότι ο επισκέπτης είναι AI.
Αυτές είναι αρχές σχεδιασμού, όχι καθολική συνταγή εγκατάστασης. Η τελική υλοποίηση εξαρτάται από την υποδομή, τις λειτουργίες του site και την τρέχουσα τεκμηρίωση κάθε παρόχου.
AI crawlers και agents: Οι διαφορές που αλλάζουν την απόφαση
Crawlers αναζήτησης και ανακάλυψης
Οι crawlers αναζήτησης συλλέγουν πληροφορίες για την ανακάλυψη και την ευρετηρίαση σελίδων. Αν θέλεις το δημόσιο περιεχόμενό σου να εμφανίζεται σε μια μηχανή αναζήτησης, η πρόσβαση του αντίστοιχου crawler είναι σημαντική προϋπόθεση, όχι εγγύηση εμφάνισης ή κατάταξης.
Μην θεωρείς ότι κάθε λειτουργία AI ενός παρόχου διαθέτει ανεξάρτητο crawler ή ανεξάρτητο διακόπτη. Οι σχέσεις ανάμεσα σε αναζήτηση, ευρετήρια και AI προϊόντα διαφέρουν. Πριν αλλάξεις έναν κανόνα, έλεγξε ποια υπηρεσία επηρεάζει πραγματικά.
Crawlers συλλογής για εκπαίδευση
Άλλος σκοπός είναι η συλλογή περιεχομένου για ανάπτυξη ή εκπαίδευση μοντέλων. Η απόφαση εδώ αφορά την πολιτική χρήσης του περιεχομένου σου, όχι μόνο την επισκεψιμότητα που περιμένεις να επιστρέψει.
Ένας publisher μπορεί να επιδιώκει την ανακάλυψη των άρθρων του αλλά να μη θέλει συγκεκριμένη χρήση τους για training. Όπου υπάρχουν διακριτοί μηχανισμοί ελέγχου, οι δύο επιλογές πρέπει να εξετάζονται χωριστά. Ένας νέος αποκλεισμός δεν αποδεικνύει ότι διαγράφονται δεδομένα που έχουν ήδη συλλεχθεί.
Retrieval bots και ανάκτηση για απαντήσεις
Η ανάκτηση αφορά την πρόσβαση σε πληροφορίες που μπορούν να χρησιμοποιηθούν κατά τη σύνθεση μιας απάντησης. Δεν ταυτίζεται αυτομάτως με την εκπαίδευση ενός μοντέλου. Επίσης, ένα σύστημα μπορεί να αξιοποιεί ευρετήρια, αποθηκευμένο περιεχόμενο ή άλλες πηγές, όχι υποχρεωτικά μια νέα επίσκεψη στο site σου για κάθε ερώτηση.
Επομένως, ένα επιτυχές request δεν αποδεικνύει ότι το brand σου αναφέρθηκε σε απάντηση. Και η απουσία νέου request δεν αποδεικνύει ότι το περιεχόμενό σου δεν χρησιμοποιήθηκε. Χρειάζεται διάκριση ανάμεσα στην τεχνική πρόσβαση και στην πραγματική προβολή.
Agents που ενεργούν για λογαριασμό χρήστη
Ένας agent μπορεί να επιχειρεί να συγκρίνει προϊόντα, να συμπληρώσει στοιχεία ή να εκτελέσει μια εργασία. Σε αυτό το επίπεδο το ερώτημα δεν είναι μόνο «επιτρέπεται να διαβάσει;», αλλά «ποια ενέργεια επιτρέπεται να κάνει και με τίνος την εξουσιοδότηση;».
Η ανάγνωση μιας δημόσιας σελίδας προϊόντος είναι διαφορετική από την αλλαγή διεύθυνσης αποστολής. Η δεύτερη χρειάζεται ελέγχους ταυτότητας, δικαιωμάτων και εγκυρότητας της ενέργειας. Η δήλωση ότι το αίτημα προέρχεται από agent δεν παρακάμπτει αυτούς τους ελέγχους.
Χώρισε το site σε ζώνες πριν χωρίσεις τα bots σε λίστες
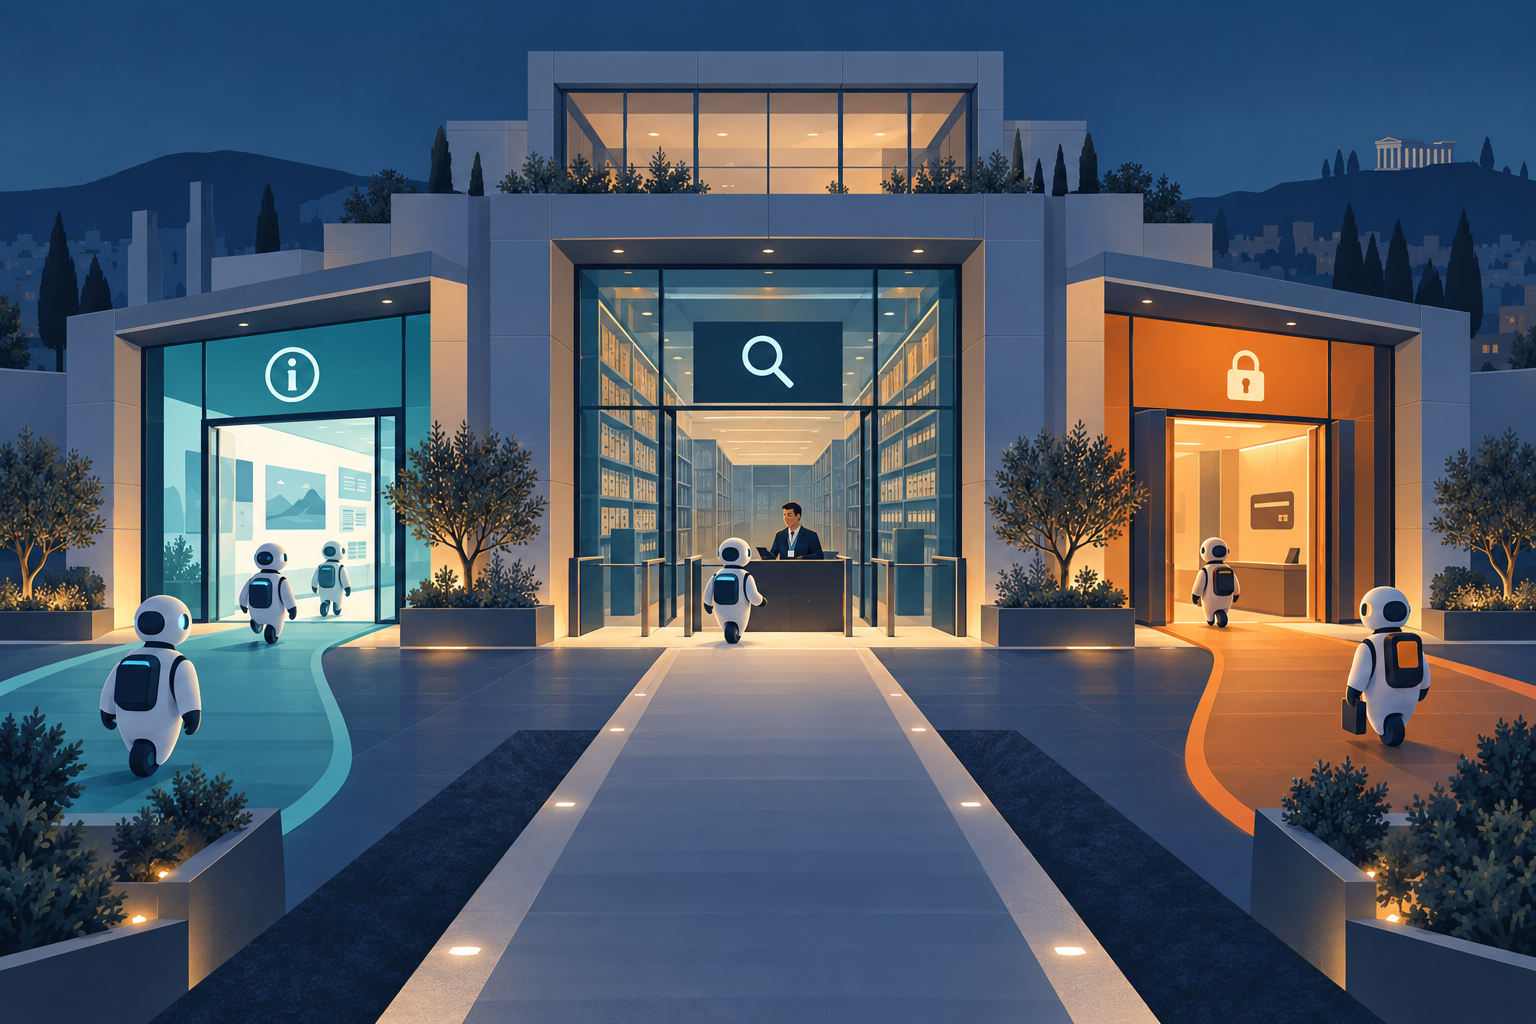
Μια χρήσιμη αφετηρία είναι να ταξινομήσεις τα URLs και τις λειτουργίες σου σε τρεις ζώνες. Έτσι η συζήτηση γίνεται συγκεκριμένη και δεν περιορίζεται σε ένα checkbox του εργαλείου ασφαλείας.
Ζώνη δημόσιας πληροφορίας
Άρθρα, σελίδες υπηρεσιών, οδηγοί, δημόσια τεχνική τεκμηρίωση και προϊόντα συνήθως ανήκουν εδώ. Για κάθε κατηγορία γράψε αν επιδιώκεις ανακάλυψη, αναφορά σε απαντήσεις, εμπορική αξιοποίηση μέσω αδειοδότησης ή κάποια διαφορετική χρήση.
Η πολιτική δεν χρειάζεται να είναι ίδια για όλο το περιεχόμενο. Ένα δημόσιο εταιρικό FAQ και μια πρωτότυπη βάση δεδομένων μπορεί να έχουν διαφορετική αξία, άδειες και περιορισμούς. Η απόφαση για δικαιώματα χρήσης χρειάζεται συντονισμό με τους υπευθύνους του περιεχομένου και, όπου απαιτείται, νομικό έλεγχο.
Ζώνη αυξημένου τεχνικού κόστους
Εσωτερική αναζήτηση, αμέτρητοι συνδυασμοί φίλτρων και δυναμικές σελίδες μπορούν να δημιουργήσουν μεγάλο αριθμό αιτημάτων. Το ζήτημα εδώ μπορεί να είναι η επιβάρυνση της εφαρμογής, όχι η αξία του περιεχομένου για training.
Εξέτασε caching, περιορισμούς ρυθμού και διαχείριση των περιττών URLs μαζί με τον developer. Μην υποθέτεις ότι ένας μεγάλος όγκος requests είναι από μόνος του επίθεση. Έλεγξε πόσο κοστίζουν, σε ποια endpoints καταλήγουν και αν επηρεάζουν την εξυπηρέτηση πραγματικών επισκεπτών.
Ζώνη ιδιωτικών δεδομένων και ενεργειών
Λογαριασμοί πελατών, στοιχεία παραγγελιών, εσωτερικά αρχεία και διαχειριστικές λειτουργίες χρειάζονται authentication και authorization. Το ίδιο ισχύει για ενέργειες που μεταβάλλουν δεδομένα, με πρόσθετες δικλίδες ανάλογα με τον κίνδυνο.
Ένα ιδιωτικό αρχείο δεν πρέπει να είναι δημόσια προσβάσιμο επειδή «δεν το έχουμε συνδέσει από το μενού». Ούτε γίνεται ασφαλές επειδή το path του εμφανίζεται σε κανόνα Disallow.
Τι κάνει το robots.txt και τι δεν μπορεί να κάνει
Το robots.txt εκφράζει οδηγίες crawling προς bots που επιλέγουν να τις τηρούν. Δεν είναι firewall, σύστημα σύνδεσης ή μηχανισμός προστασίας εμπιστευτικών πληροφοριών. Ένας επισκέπτης που αγνοεί τις οδηγίες του μπορεί να συνεχίσει να ζητά δημόσια προσβάσιμα URLs.
Επίσης, ο περιορισμός crawling δεν ισοδυναμεί απαραίτητα με αφαίρεση ενός URL από τα αποτελέσματα αναζήτησης. Αν ο στόχος είναι να μη γίνεται index μια σελίδα, χρειάζεται κατάλληλη αντιμετώπιση με βάση την περίσταση. Για παράδειγμα, μια μηχανή πρέπει να μπορεί να ανακτήσει μια δημόσια σελίδα για να δει μια οδηγία noindex που βρίσκεται σε αυτή. Για πραγματικά ιδιωτικό περιεχόμενο, η λύση είναι ο έλεγχος πρόσβασης.
Αντίστοιχα, ένα llms.txt δεν αντικαθιστά την πολιτική ασφαλείας ή τους ελέγχους πρόσβασης. Η ύπαρξη ενός αρχείου που περιγράφει περιεχόμενο δεν σημαίνει ότι επιβάλλει κανόνες χρήσης σε τρίτους.
Όταν απαιτείται τεχνική επιβολή περιορισμών, εξετάζονται εργαλεία στο επίπεδο CDN, WAF, server ή εφαρμογής. Η διαθεσιμότητα και η συμπεριφορά τους εξαρτώνται από τον πάροχο και τη ρύθμιση. Γι’ αυτό ένας έτοιμος κανόνας που λειτουργεί αλλού δεν πρέπει να αντιγράφεται χωρίς έλεγχο.
Πριν μπλοκάρεις: Έλεγξε τα logs, όχι μόνο το όνομα του bot
Το user agent είναι μια δήλωση ταυτότητας μέσα στο αίτημα. Δεν αποτελεί από μόνο του απόδειξη προέλευσης. Ένα script μπορεί να δηλώσει το όνομα ενός γνωστού crawler χωρίς να σχετίζεται με τον οργανισμό που τον λειτουργεί.
Ζήτησε από την τεχνική ομάδα να εξετάσει:
- Ποια paths ζητούνται και με ποια HTTP methods.
- Πόσο συχνά επαναλαμβάνονται τα requests και αν εμφανίζονται απότομες αιχμές.
- Ποιους κωδικούς απόκρισης λαμβάνουν και πόσα δεδομένα μεταφέρονται.
- Αν τα αιτήματα εξυπηρετούνται από cache ή φτάνουν στον origin server.
- Αν υπάρχει αυξημένος χρόνος απόκρισης, επιβάρυνση εφαρμογής ή αύξηση σφαλμάτων.
- Αν η προέλευση μπορεί να επαληθευτεί με τις μεθόδους που τεκμηριώνει ο συγκεκριμένος πάροχος.
Όπου υποστηρίζεται, η επαλήθευση μπορεί να περιλαμβάνει δημοσιευμένα IP ranges ή συγκεκριμένους ελέγχους DNS. Δεν χρησιμοποιούμε όμως μια γενική μέθοδο για όλους και δεν θεωρούμε μόνιμη μια παλιά λίστα διευθύνσεων.
Πρόσεξε και το σημείο μέτρησης. Τα origin logs δεν περιλαμβάνουν απαραίτητα όσα εξυπηρετήθηκαν από το CDN, ενώ ένα dashboard μπορεί να δείχνει δείγμα και όχι το σύνολο των αιτημάτων. Τα logs μπορεί επίσης να περιέχουν προσωπικά δεδομένα: χρειάζονται περιορισμένη πρόσβαση, κατάλληλη διατήρηση και αποφυγή άσκοπης καταγραφής ευαίσθητων πληροφοριών.
Ένα υποθετικό e-shop: Τρεις διαφορετικές αποφάσεις, όχι ένα γενικό block
Ας υποθέσουμε ότι ένα ελληνικό e-shop βλέπει αυτοματοποιημένες επισκέψεις σε προϊόντα, φίλτρα αναζήτησης και σελίδες λογαριασμού. Το παράδειγμα είναι υποθετικό και δεν περιγράφει μετρήσεις του Grow Digital ή πραγματικού πελάτη.
Πρώτη περίπτωση: επαληθευμένος crawler διαβάζει δημόσια προϊόντα με διαχειρίσιμο ρυθμό. Η ομάδα θέλει τα προϊόντα ανακαλύψιμα, οπότε διατηρεί πρόσβαση και παρακολουθεί κόστος και διαθεσιμότητα. Δεν συμπεραίνει ότι κάθε επίσκεψη θα φέρει citation ή πώληση.
Δεύτερη περίπτωση: ένας επισκέπτης ζητά συνεχώς διαφορετικούς συνδυασμούς φίλτρων, επιβαρύνοντας την εφαρμογή. Η ομάδα εξετάζει περιορισμούς στα συγκεκριμένα endpoints και βελτιώσεις caching. Δεν κλείνει όλο το site επειδή το πρόβλημα εντοπίζεται σε ένα τμήμα του.
Τρίτη περίπτωση: ένας agent επιχειρεί να αποκτήσει πρόσβαση σε στοιχεία παραγγελίας. Η πρόσβαση απαιτεί την προβλεπόμενη εξουσιοδότηση του πελάτη. Χωρίς αυτή, το αίτημα απορρίπτεται ανεξάρτητα από το brand που δηλώνει ο agent.
Αν η επιχείρηση αποφασίσει επιπλέον ότι δεν επιτρέπει συγκεκριμένη χρήση για training, εξετάζει ξεχωριστά τους διαθέσιμους ελέγχους και τους όρους του παρόχου. Δεν θεωρεί ότι η απόφαση για training πρέπει υποχρεωτικά να ακυρώσει κάθε μορφή δημόσιας ανακάλυψης.
Μέτρηση: Requests, αναφορές και έσοδα δεν είναι το ίδιο
Η συζήτηση για την αξία που επιστρέφει το AI στους δημιουργούς περιεχομένου είναι σημαντική. Για να γίνει όμως επιχειρηματική απόφαση, χρειάζεται να ξεχωρίσεις τις μετρήσεις και τους περιορισμούς τους.
Τα server και CDN logs περιγράφουν αιτήματα. Τα analytics καταγράφουν αλληλεπιδράσεις που μπορεί να μετρήσει η εγκατάστασή σου. Πολλά bot requests δεν εκτελούν το JavaScript της σελίδας και δεν εμφανίζονται ως κανονικές επισκέψεις στο GA4. Συνεπώς, δεν υπάρχει αντιστοίχιση ένα request προς ένα session.
Κράτησε χωριστά τέσσερις ομάδες δεικτών:
- Πρόσβαση: επαληθευμένα requests, κατηγορίες URLs, επιτυχείς και απορριφθείσες αποκρίσεις.
- Τεχνικό κόστος: origin load, bandwidth, σφάλματα και χρόνοι απόκρισης.
- Ορατότητα: αναφορές ή παραπομπές σε ένα σταθερό δείγμα ερωτήσεων, με καταγεγραμμένη μεθοδολογία.
- Επιχειρηματική αξία: αναγνωρίσιμες παραπομπές, ποιοτικά leads και συναλλαγές όπου υπάρχει επαρκής τεκμηρίωση προέλευσης.
Μια αναφορά σε απάντηση δεν αποδεικνύει incremental έσοδο. Αντίστροφα, μηδενικές αναγνωρίσιμες παραπομπές δεν αποδεικνύουν μηδενική επίδραση. Κράτησε τις αβεβαιότητες ορατές αντί να κατασκευάζεις ένα ενιαίο «AI ROI» από ασύμβατα δεδομένα.
Πώς εφαρμόζεις αλλαγές χωρίς να δημιουργήσεις πρόβλημα στο SEO
Οι αλλαγές πρόσβασης χρειάζονται ιδιοκτήτη, καταγραφή και δυνατότητα επιστροφής στην προηγούμενη κατάσταση. Ο marketing υπεύθυνος ορίζει τον επιχειρηματικό στόχο, ο developer ή η ομάδα ασφαλείας επιλέγει την τεχνική υλοποίηση και ο SEO υπεύθυνος ελέγχει τις συνέπειες στην πρόσβαση σημαντικών σελίδων.
Ξεκίνα από περιορισμένο πεδίο όταν ο κίνδυνος το επιτρέπει. Αν το εργαλείο προσφέρει λειτουργία παρατήρησης, εξέτασέ την πριν ενεργοποιήσεις έναν ευρύ αποκλεισμό. Σε ενεργό περιστατικό ασφαλείας, βέβαια, προτεραιότητα έχει η αντιμετώπιση και όχι μια μακρά δοκιμή.
Μετά την αλλαγή, έλεγξε δημόσιες σελίδες, λήψη απαραίτητων πόρων, φόρμες, συνδέσεις λογαριασμών και checkout. Ένα challenge που μπορεί να ολοκληρώσει άνθρωπος ενδέχεται να εμποδίζει έναν θεμιτό crawler. Μην προσθέτεις όμως εξαιρέσεις ασφαλείας μόνο βάσει του δηλωμένου user agent.
Παρακολούθησε και τα διαθέσιμα εργαλεία ελέγχου URL της μηχανής αναζήτησης. Η επιτυχία ενός μεμονωμένου τεστ δεν εγγυάται ότι κάθε URL και κάθε συνθήκη καλύπτονται. Συνδύασε δείγματα ελέγχων με logs και παρακολούθηση σφαλμάτων.
Checklist πολιτικής AI bots για marketing και developer
- Κατάγραψε τον στόχο: ανακάλυψη, προστασία περιεχομένου, περιορισμός κόστους ή αντιμετώπιση συγκεκριμένης απειλής.
- Χαρτογράφησε το site: δημόσιο περιεχόμενο, ακριβά δυναμικά endpoints, ιδιωτικά δεδομένα και συναλλαγές.
- Επιβεβαίωσε τις ταυτότητες: ξεχώρισε επαληθευμένους παρόχους από απλές δηλώσεις user agent.
- Διάβασε την τρέχουσα τεκμηρίωση: έλεγξε τον σκοπό κάθε crawler και ποια προϊόντα επηρεάζει κάθε ρύθμιση.
- Κατέγραψε ξεχωριστές αποφάσεις: αναζήτηση, training, retrieval και εκτέλεση ενεργειών δεν είναι μία ενιαία άδεια.
- Επίλεξε κατάλληλο μηχανισμό: οδηγίες crawling, rate limiting, WAF ή έλεγχος πρόσβασης, ανάλογα με το πρόβλημα.
- Όρισε μετρήσεις και όρια: τι θα παρακολουθείς και ποια μεταβολή δικαιολογεί επανεξέταση.
- Προετοίμασε rollback: κράτησε προηγούμενες ρυθμίσεις και όρισε ποιος επαναφέρει τη λειτουργία αν κάτι πάει λάθος.
- Έλεγξε τις κρίσιμες διαδρομές: crawling, δημόσια προβολή, login, φόρμες και συναλλαγές.
- Βάλε ημερομηνία επανελέγχου: η πολιτική χρειάζεται συντήρηση όταν αλλάζουν υπηρεσίες, υποδομή ή επιχειρηματικοί στόχοι.
Συμπέρασμα: Η σωστή μονάδα απόφασης δεν είναι «όλο το AI»
Δεν χρειάζεται να διαλέξεις ανάμεσα σε ένα απροστάτευτο site και σε ένα site κλειστό σε κάθε αυτοματοποιημένο επισκέπτη. Χρειάζεται να ξέρεις τι θέλεις να είναι δημόσιο, ποιες χρήσεις επιτρέπεις και ποιες ενέργειες απαιτούν εξουσιοδότηση.
Αποφάσισε ανά σκοπό, περιοχή του site και πραγματική συμπεριφορά. Επαλήθευσε αντί να εμπιστεύεσαι μια ετικέτα, μέτρησε αντί να υποθέτεις και κράτησε τις αλλαγές αναστρέψιμες. Αυτή είναι πιο χρήσιμη στρατηγική από μια block list που μεγαλώνει χωρίς να γνωρίζεις τι προστατεύει και τι αποκλείει.
Πηγές και όρια του οδηγού
Αφορμή για το θέμα αποτέλεσαν οι περιλήψεις RSS των παρακάτω δημοσιευμάτων του Search Engine Journal. Το παρόν είναι συντακτικό πλαίσιο αποφάσεων, όχι αναφορά δοκιμών σε συγκεκριμένο site. Δεν αναπαράγει στατιστικά των δημοσιευμάτων και δεν παρουσιάζει τις λειτουργίες κάποιου παρόχου ως ζωντανά επαληθευμένες.